
Одна ошибка Unicode в Rust, три модели кодинга: воспроизводимое сравнение

Недавняя статья на Dev.to предлагает стандартизированный метод оценки навыков программирования больших языковых моделей (LLM) с использованием конкретной задачи на Rust. Автор выделяет распространенную ошибку, при которой нарезка строки UTF-8 по границе байтов вызывает панику при встрече с многобайтовыми символами Unicode. Используя эту воспроизводимую ошибку в качестве эталона, автор сравнивает производительность DeepSeek V4 Pro, Claude Fable 5.1 и Grok Build 0.1. Вместо того чтобы полагаться на субъективные рейтинги, оценка фокусируется на объективных критериях: компилируется ли патч модели, проходит ли он регрессионные тесты и корректно ли обрабатывает граничные случаи, такие как эмодзи, не вводя лишних зависимостей. Статья предоставляет структурированную базу для разработчиков, позволяющую проводить собственные тесты, подчеркивая, что лучшая модель для кодинга часто зависит от задачи и должна оцениваться через строгое, воспроизводимое тестирование, а не через маркетинговые заявления.
This is a summary. Read the full article at the original source:
Dev.toПохожие

Паттерны параллельных субагентов в Claude Code: Fan-Out, Fan-In и стратегии синхронизации, которые действительно работают
В статье рассматриваются эффективные стратегии управления параллельными ИИ-субагентами в разработке ПО, с особым вниманием к проблемам загрязнения кон…

Sphinx — это новый инструмент для разработчиков, предназначенный для повышения надежности кода, созданного искусственным интеллектом, перед его отправ…
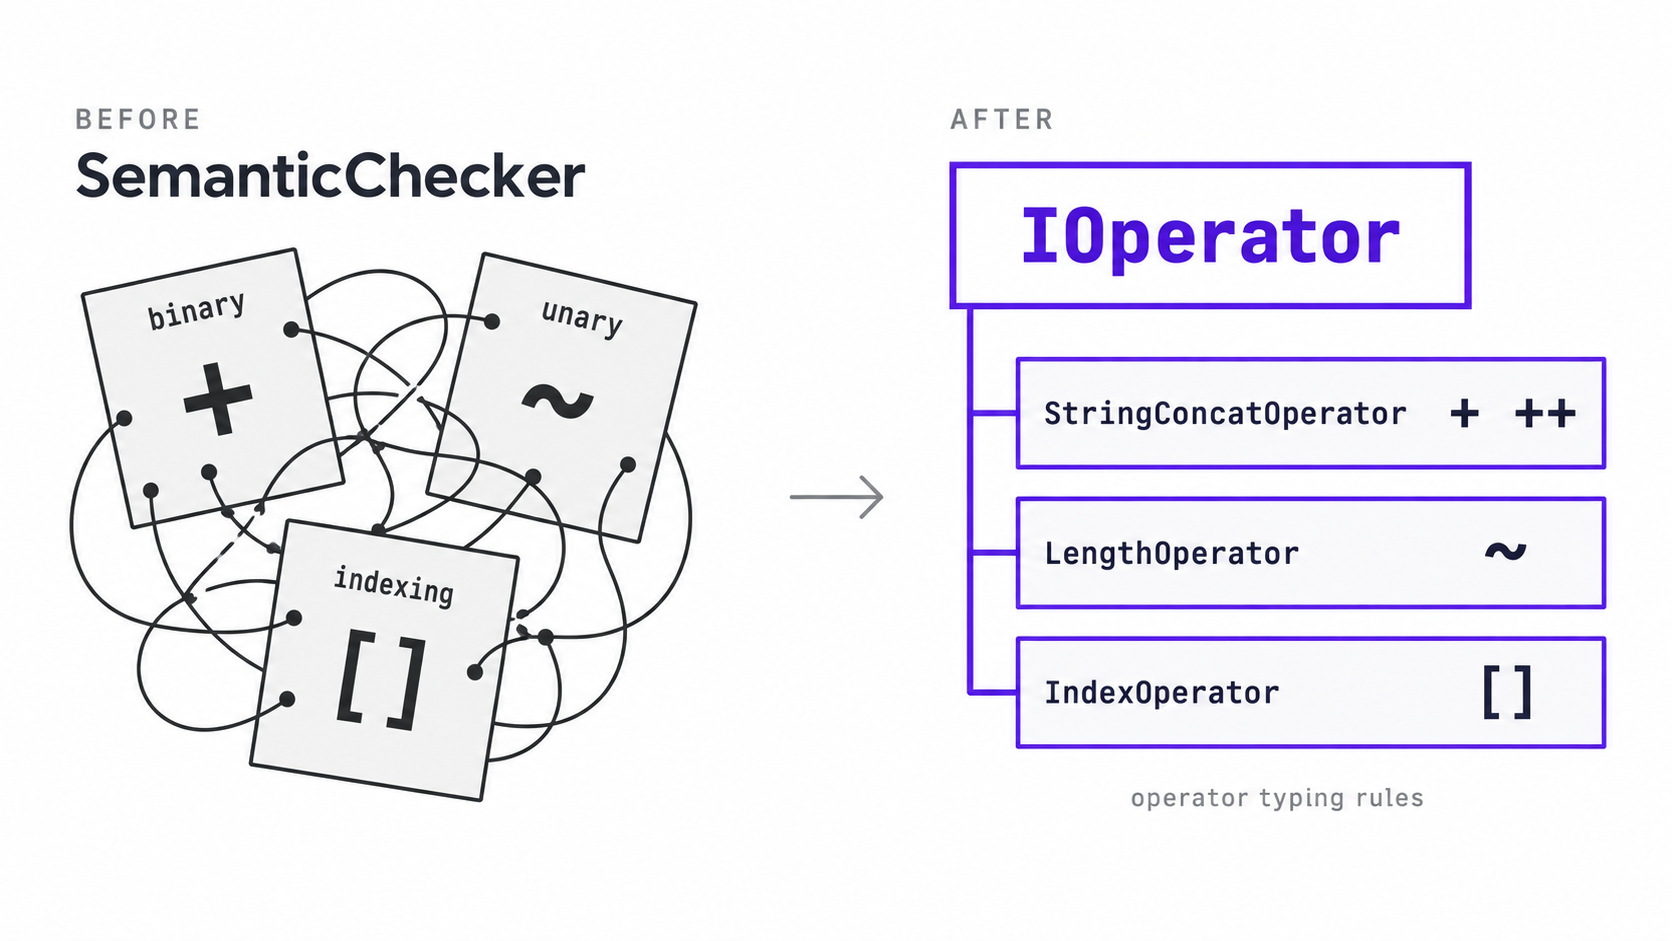
Автор интерпретируемого языка программирования HydraScript, написанного на C#, рассказал о процессе внедрения поддержки индексации строк и получения и…