
Как индексация строк изменила систему типов HydraScript
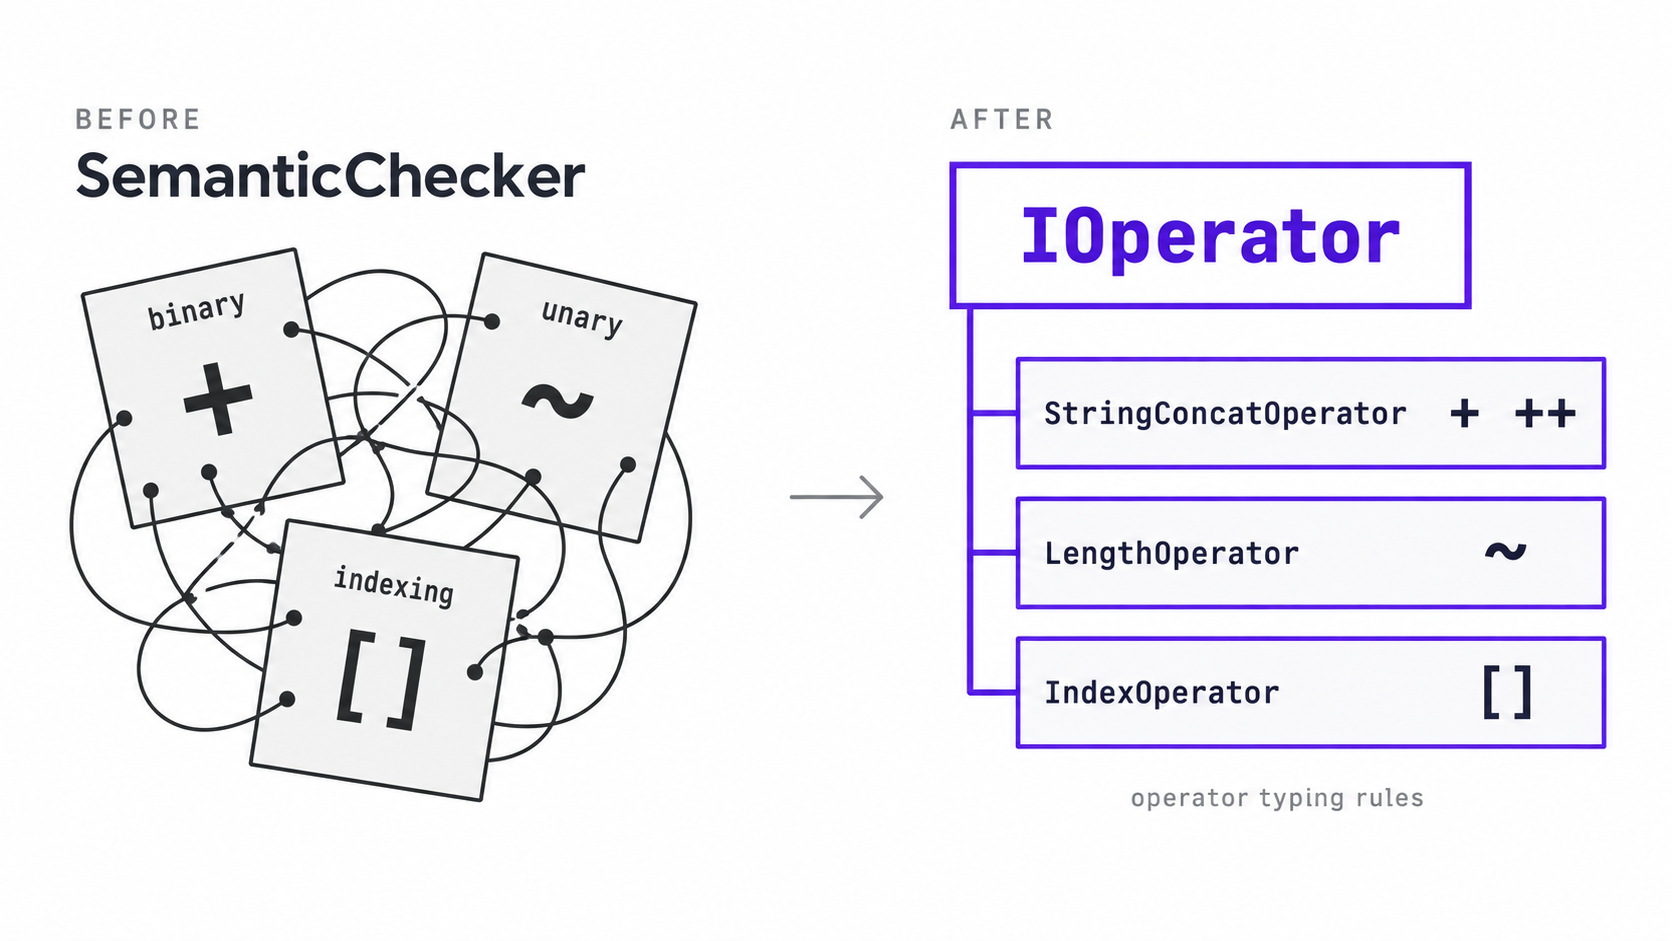
Автор интерпретируемого языка программирования HydraScript, написанного на C#, рассказал о процессе внедрения поддержки индексации строк и получения их длины. Ранее эти операции были доступны только для массивов, а логика работы с типами была разбросана по разным частям семантического анализатора. В ходе реализации поддержки синтаксиса text[index] разработчику пришлось пересмотреть архитектуру анализатора, чтобы централизовать правила обработки типов. Поскольку HydraScript является статически типизированным языком, основной задачей стала проверка допустимости операций на этапе анализа, а не исполнения. Это изменение позволило не только добавить функциональность, но и значительно упростить структуру кода, сделав систему типов более предсказуемой и удобной для дальнейшего расширения. Статья подробно описывает технические трудности, с которыми столкнулся автор при интеграции новых возможностей в семантический анализатор своего проекта.
This is a summary. Read the full article at the original source:
HabrПохожие
DBML Diagram 1.0.1: новые возможности для работы со схемами БД в JetBrains
Вышла версия 1.0.1 плагина DBML Diagram для IntelliJ IDEA, предназначенного для визуализации и проектирования баз данных. Основное обновление включает…
Статья представляет проект РУСИ++, направленный на внедрение русского языка в системное программирование с C-подобным синтаксисом. Автор модифицировал…
Статья на Habr поднимает критический вопрос качества промышленного дизайна и ответственности разработчиков перед конечным потребителем. Автор делится…