
Локальный ИИ на четырех Mac: емкость MLX, скорость и границы доверия

Apple продемонстрировала использование фреймворка MLX для запуска крупномасштабных моделей, таких как Muse Spark Open от Meta, на кластере из четырех Mac Studio с чипами M5 Ultra. Использование RDMA-over-Thunderbolt позволяет обойти ограничения памяти, препятствующие работе таких моделей на одном устройстве. Однако автор подчеркивает, что добавление оборудования не гарантирует удвоения скорости генерации, так как конвейерный параллелизм часто сохраняет последовательную обработку слоев. В статье отмечается, что хотя локальный вывод данных повышает конфиденциальность, пользователям необходимо тщательно тестировать свои рабочие нагрузки, так как производительность сильно зависит от архитектуры модели и топологии связи. Также важно различать скорость обработки промптов и генерации токенов. Автор предупреждает, что локальный хостинг модели не гарантирует безопасность всех сопутствующих сервисов, что подтверждается недавним инцидентом с OpenCode. Покупателям рекомендуется проводить собственные тесты, а не полагаться исключительно на бенчмарки производителя.
This is a summary. Read the full article at the original source:
Dev.toПохожие

Детектор дрейфа, который «кричит волки», хуже, чем его отсутствие
В недавней статье разработчик Дебашиш Госал обсуждает проблемы создания надежного обнаружения дрейфа для ИИ-агентов в рамках HivePlane. Автор подчерки…
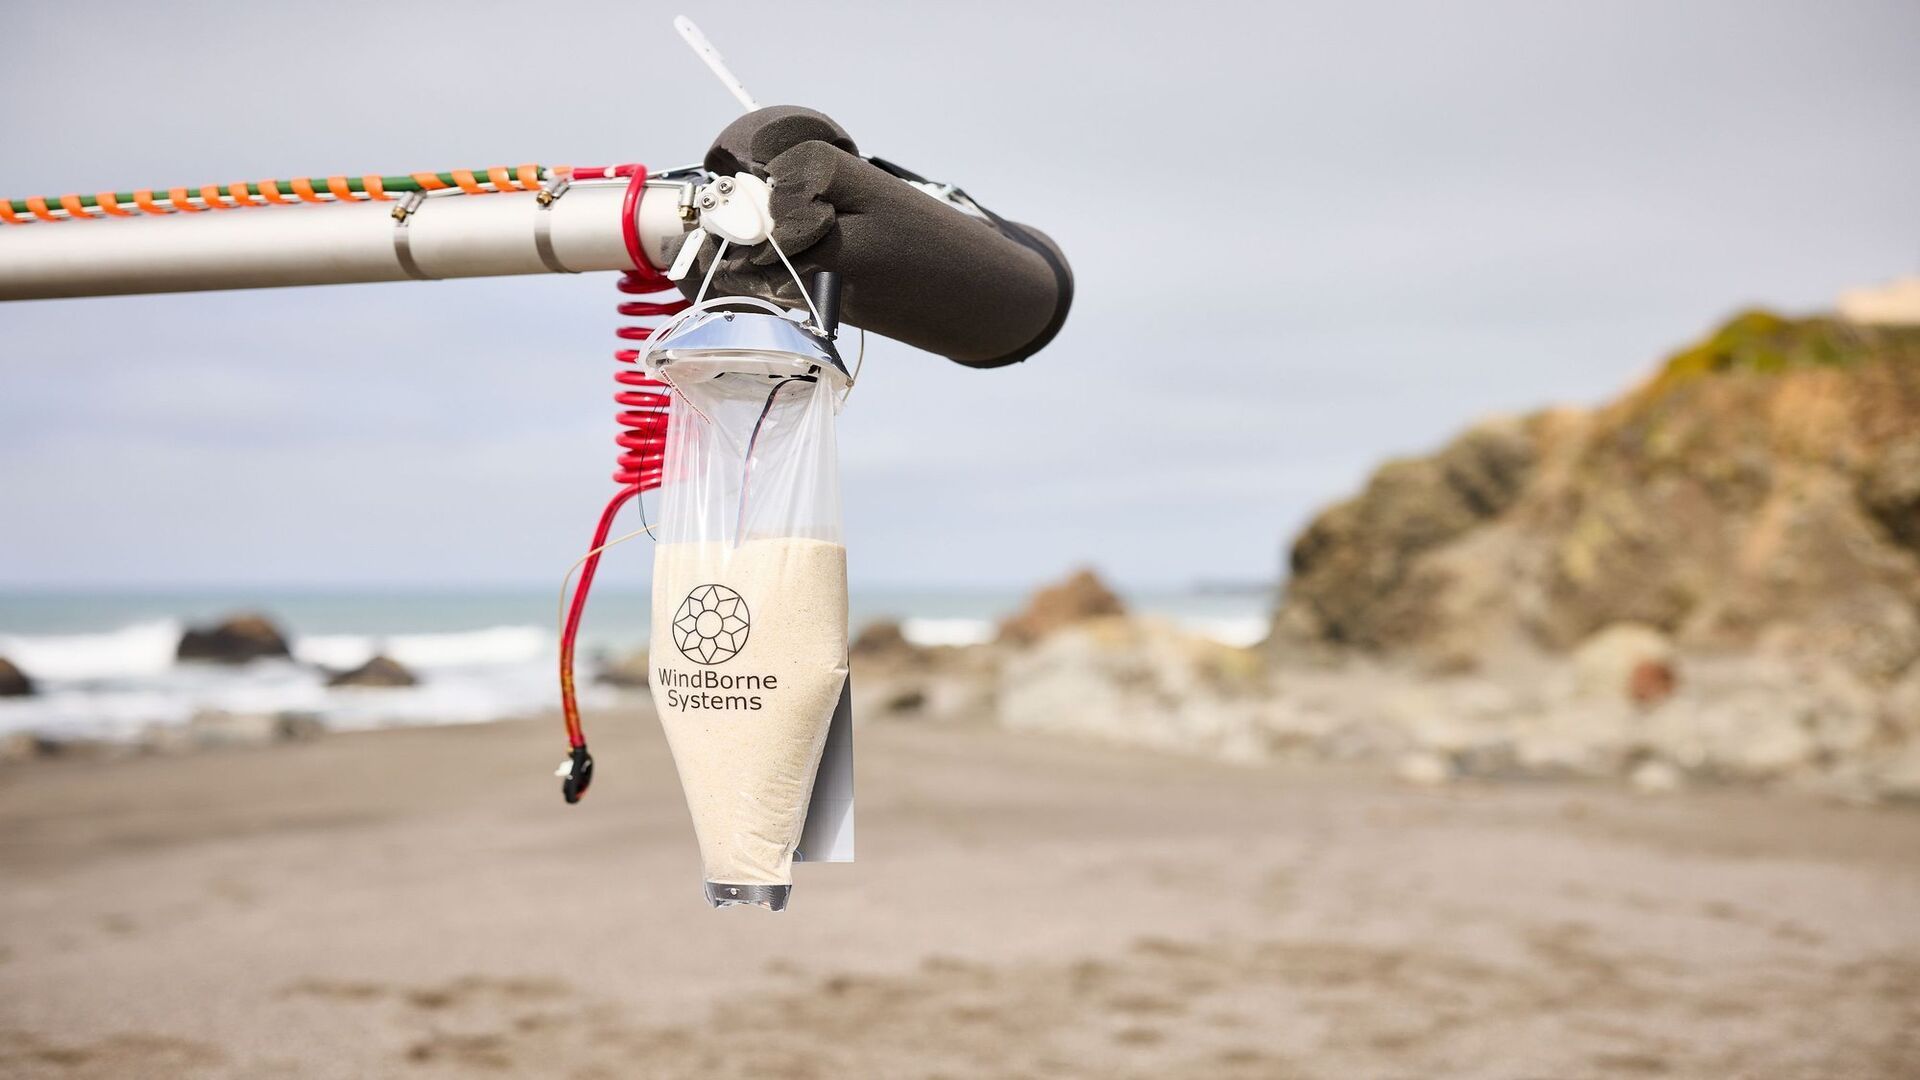
ВВС США заключили контракт на 49 миллионов долларов на данные с автономных метеозондов
Компания WindBorne Systems получила контракт с ВВС США на сумму до 49 миллионов долларов на предоставление атмосферных данных, собираемых флотом из 70…

SDLC, ADLC и ASDLC: Разграничение методологий разработки ИИ
В недавнем анализе разработчик Ремо Янсен обращает внимание на путаницу в терминологии современной разработки ПО, в частности, на пересекающиеся опред…