
Как мы научили LLMCOD собирать базу знаний не только из HTML, но и из SPA и открытых API

Разработчики сервиса LLMCOD представили обновление, расширяющее возможности создания баз знаний для RAG-систем. Традиционный метод парсинга HTML-кода становится неэффективным для современных SPA-сайтов, где контент динамически подгружается через JavaScript и API. Команда LLMCOD реализовала механизм, позволяющий системе взаимодействовать с API и обрабатывать данные, которые не отображаются в исходном коде страницы. В статье подробно описываются технические сложности, с которыми столкнулись разработчики при интеграции этих методов, и объясняется, почему одного векторного поиска оказалось недостаточно для качественного извлечения информации. Новое решение позволяет более эффективно индексировать сложные веб-ресурсы, обеспечивая полноту данных для работы LLM. Авторы делятся опытом преодоления ограничений классического скрапинга и подчеркивают важность адаптации инструментов под современные архитектуры веб-приложений.
This is a summary. Read the full article at the original source:
HabrПохожие

Недавний обзор ИИ-агента «Instinct» подчеркивает двойственную природу новых автономных цифровых помощников. Автор сообщает, что инструмент успешно спр…
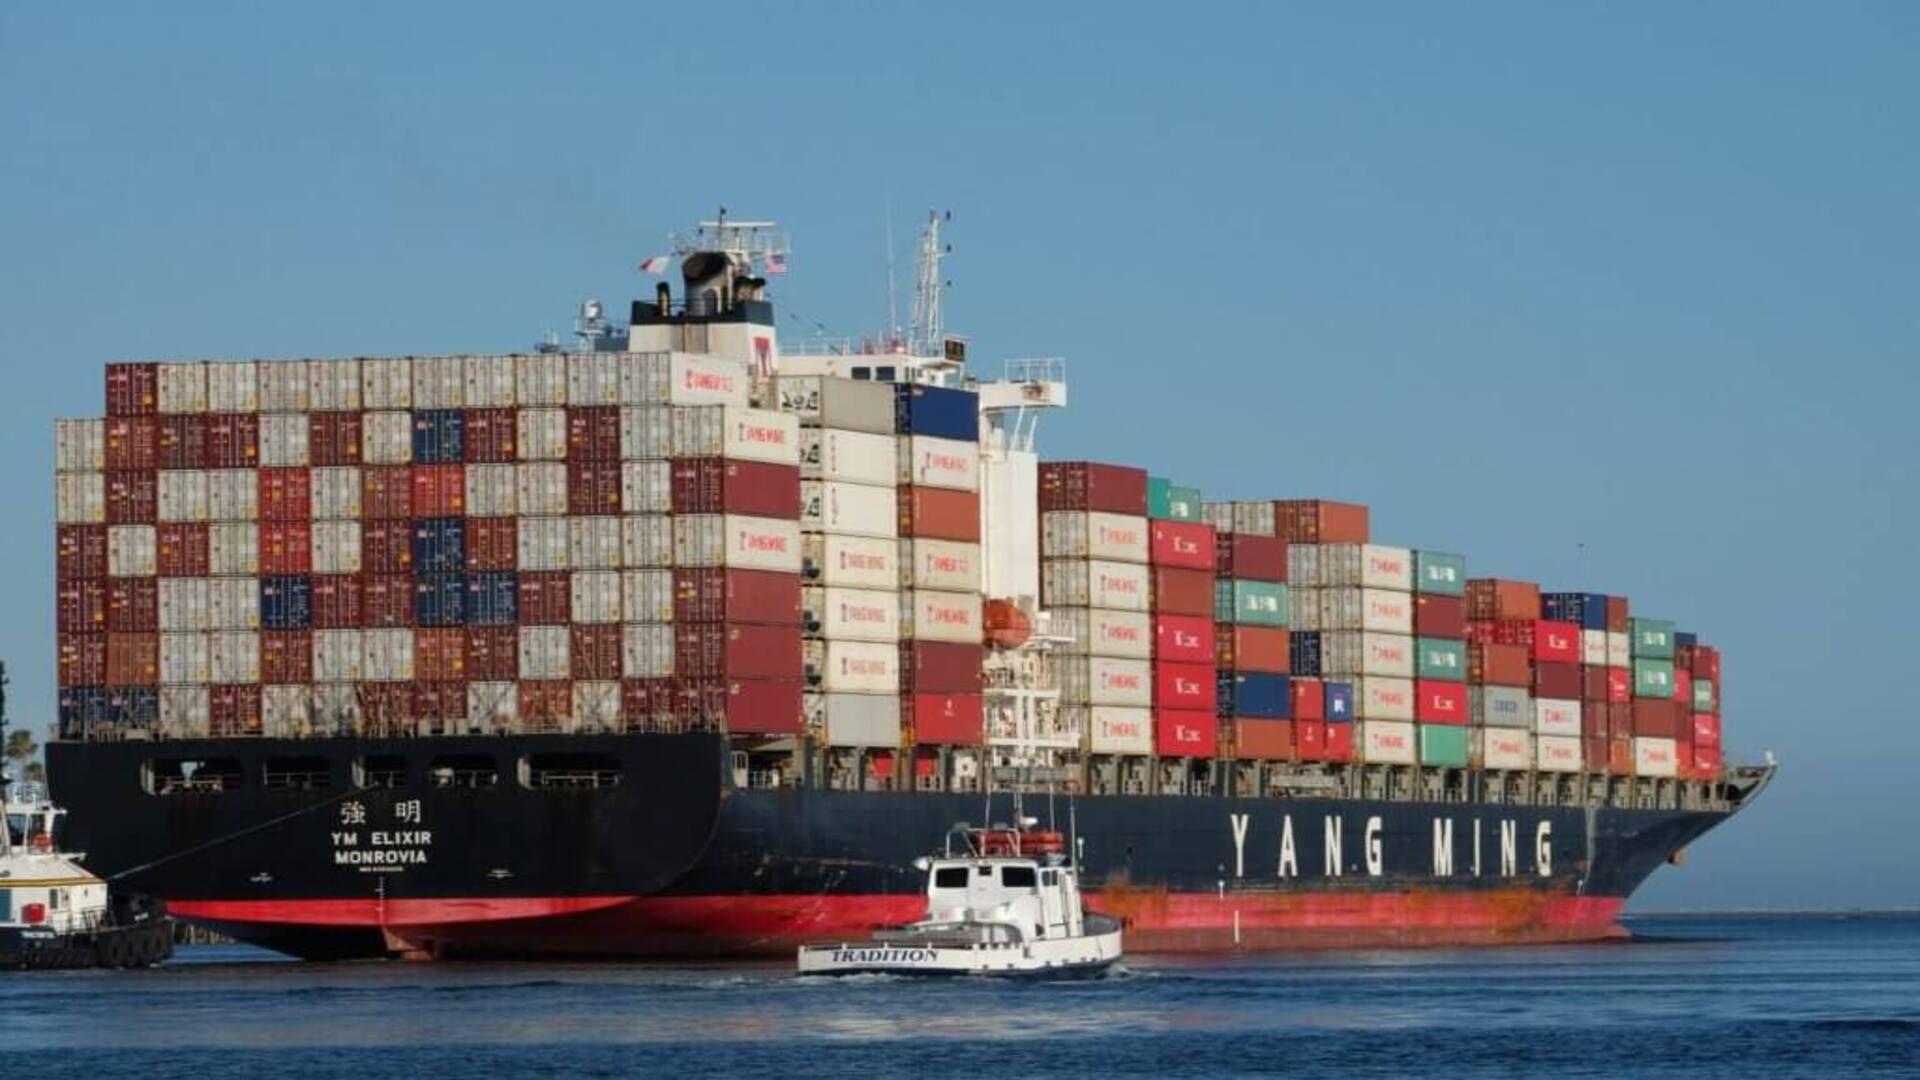
Армия США едва не захватила китайское судно из-за галлюцинации искусственного интеллекта
Военная операция США едва не переросла в международный конфликт после того, как отчет разведки, созданный искусственным интеллектом, ошибочно указал н…

PrismML внедряет свои компактные LLM в умные очки на базе Qualcomm
Компания PrismML объявила о стратегическом шаге по внедрению своих специализированных компактных больших языковых моделей (LLM) в умные очки, оснащенн…