
Model Context Protocol-ի խոցելիությունը բացահայտում է AI գործակալների հաղորդակցման ռիսկերը

Անկախ հետազոտող Սայեդ Անաս Մոհիուդդինը բացահայտել է Model Context Protocol (MCP)-ի՝ AI գործակալների միջև հաղորդակցման ստանդարտի լուրջ անվտանգային թերություններ: Հետազոտությունը ցույց է տալիս, որ հարձակվողները կարող են օգտագործել ներքին ցանցերի վստահության բացերը՝ հրամանների ներարկման (prompt injection) հարձակումներ իրականացնելու համար: Վնասակար դերակատարները, վտանգելով մեկ գործակալի, կարող են վնասակար հրահանգներ տարածել այլ կապակցված գործակալների միջև՝ հանգեցնելով տվյալների արտահոսքի և գաղտնի տեղեկատվության հասանելիության: Google-ը, JP Morgan Chase-ը և մի շարք պետական կառույցներ արդեն ընդունել են այս փոխգործակցության հետ կապված խոցելիությունների առկայությունը: Բացահայտումները ընդգծում են կառուցվածքային թուլությունը այն հարցում, թե ինչպես են AI գործակալները ներկայումս կառավարում վստահությունը: Քանի որ կազմակերպությունները գնալով ավելի շատ են օգտագործում ինքնավար գործակալներ, հետազոտությունը շեշտում է անվտանգության ավելի կոշտ արձանագրությունների անհրաժեշտությունը՝ կանխելու համար չարտոնված գործողությունները:
This is a summary. Read the full article at the original source:
Ars TechnicaԿապակցված

Նիդերլանդների և Իտալիայի հետազոտողները ներկայացրել են նոր գրոհ, որն ընդլայնում է Spectre-v2 խոցելիությունների դասը: Ի տարբերություն 2018 թվականի օրիգի…

ClingSTUN անունը ստացած նոր Linux-ի վրա հիմնված բեքդորը ակտիվորեն թիրախավորում է խոցելի «Իրերի ինտերնետ» (IoT) սարքերը՝ դրանք պրոքսի հանգույցների վերա…
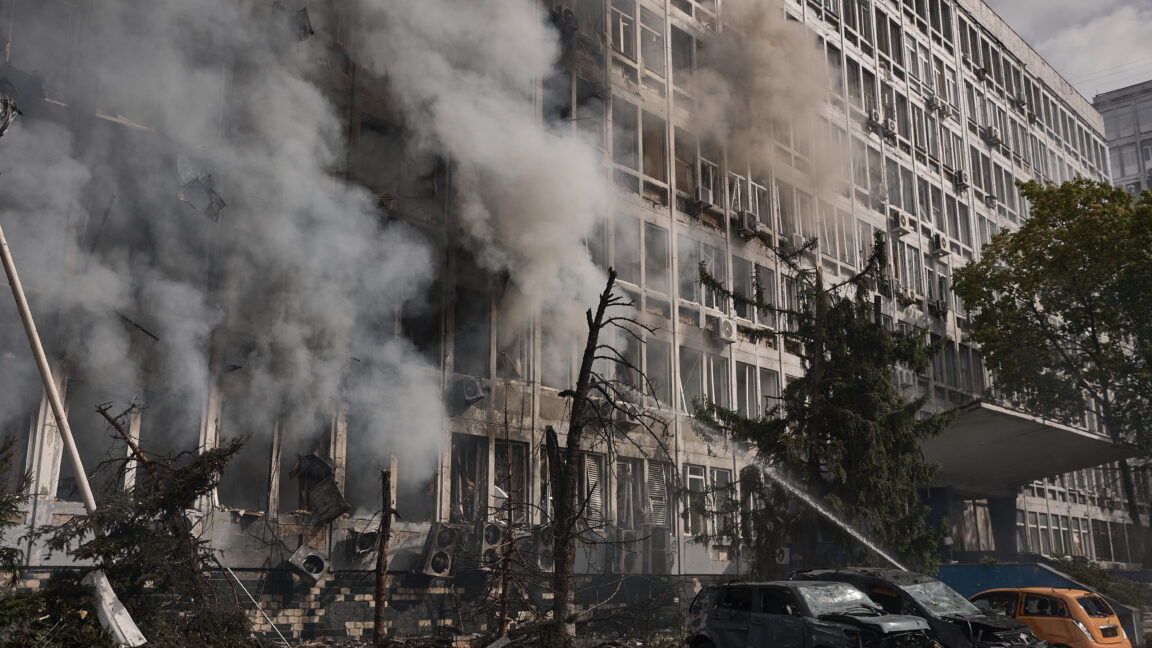
Ռուսական անօդաչու թռչող սարքերի հարվածները թիրախավորում են ուկրաինական տվյալների կենտրոններն ու հեռահաղորդակցության ենթակառուցվածքները
Ռուսական ռեակտիվ անօդաչու թռչող սարքերի հարվածների վերջին սրացումը հատուկ թիրախավորել է Կիևի տվյալների կենտրոններն ու հեռահաղորդակցության ենթակառուցվա…