
Rust-ի մեկ Unicode սխալ, երեք ծրագրավորման մոդել. վերարտադրելի համեմատություն

Dev.to-ում հրապարակված վերջին հոդվածն առաջարկում է Rust-ի կոնկրետ ծրագրավորման խնդրի միջոցով լեզվական մոդելների (LLM) կոդավորման կարողությունները գնահատելու ստանդարտացված մեթոդ: Հեղինակը մատնանշում է տարածված սխալ, երբ UTF-8 տողը բայթային սահմանով կտրելը հանգեցնում է խափանման (panic), եթե հանդիպում են բազմաբայթ Unicode նիշեր: Օգտագործելով այս վերարտադրելի սխալը որպես չափանիշ՝ հեղինակը համեմատում է DeepSeek V4 Pro, Claude Fable 5.1 և Grok Build 0.1 մոդելների աշխատանքը: Փոխարենը հիմնվելու սուբյեկտիվ վարկանիշների վրա՝ գնահատումը կենտրոնանում է օբյեկտիվ չափանիշների վրա. արդյո՞ք մոդելի առաջարկած լուծումը կոմպիլյացվում է, անցնում է թեստերը և ճիշտ է մշակում եզրային դեպքերը, ինչպիսիք են էմոջիները: Հոդվածը տրամադրում է կառուցվածքային շրջանակ ծրագրավորողների համար՝ սեփական թեստավորումներն իրականացնելու համար՝ ընդգծելով, որ լավագույն մոդելը հաճախ կախված է կոնկրետ առաջադրանքից և պահանջում է խիստ, վերարտադրելի ստուգումներ:
This is a summary. Read the full article at the original source:
Dev.toԿապակցված

Claude Code-ի զուգահեռ ենթագործակալների օրինաչափությունները. Fan-Out, Fan-In և համաժամացման ռազմավարություններ, որոնք իսկապես աշխատում են
Այս հոդվածը ներկայացնում է ծրագրային ապահովման մշակման մեջ AI ենթագործակալների զուգահեռ կառավարման արդյունավետ ռազմավարություններ՝ անդրադառնալով համատ…

Sphinx-ը նոր ծրագրավորման գործիք է, որը նախատեսված է AI-ի կողմից գրված կոդի հուսալիությունը բարելավելու համար՝ նախքան այն պահեստարան (repository) ուղա…
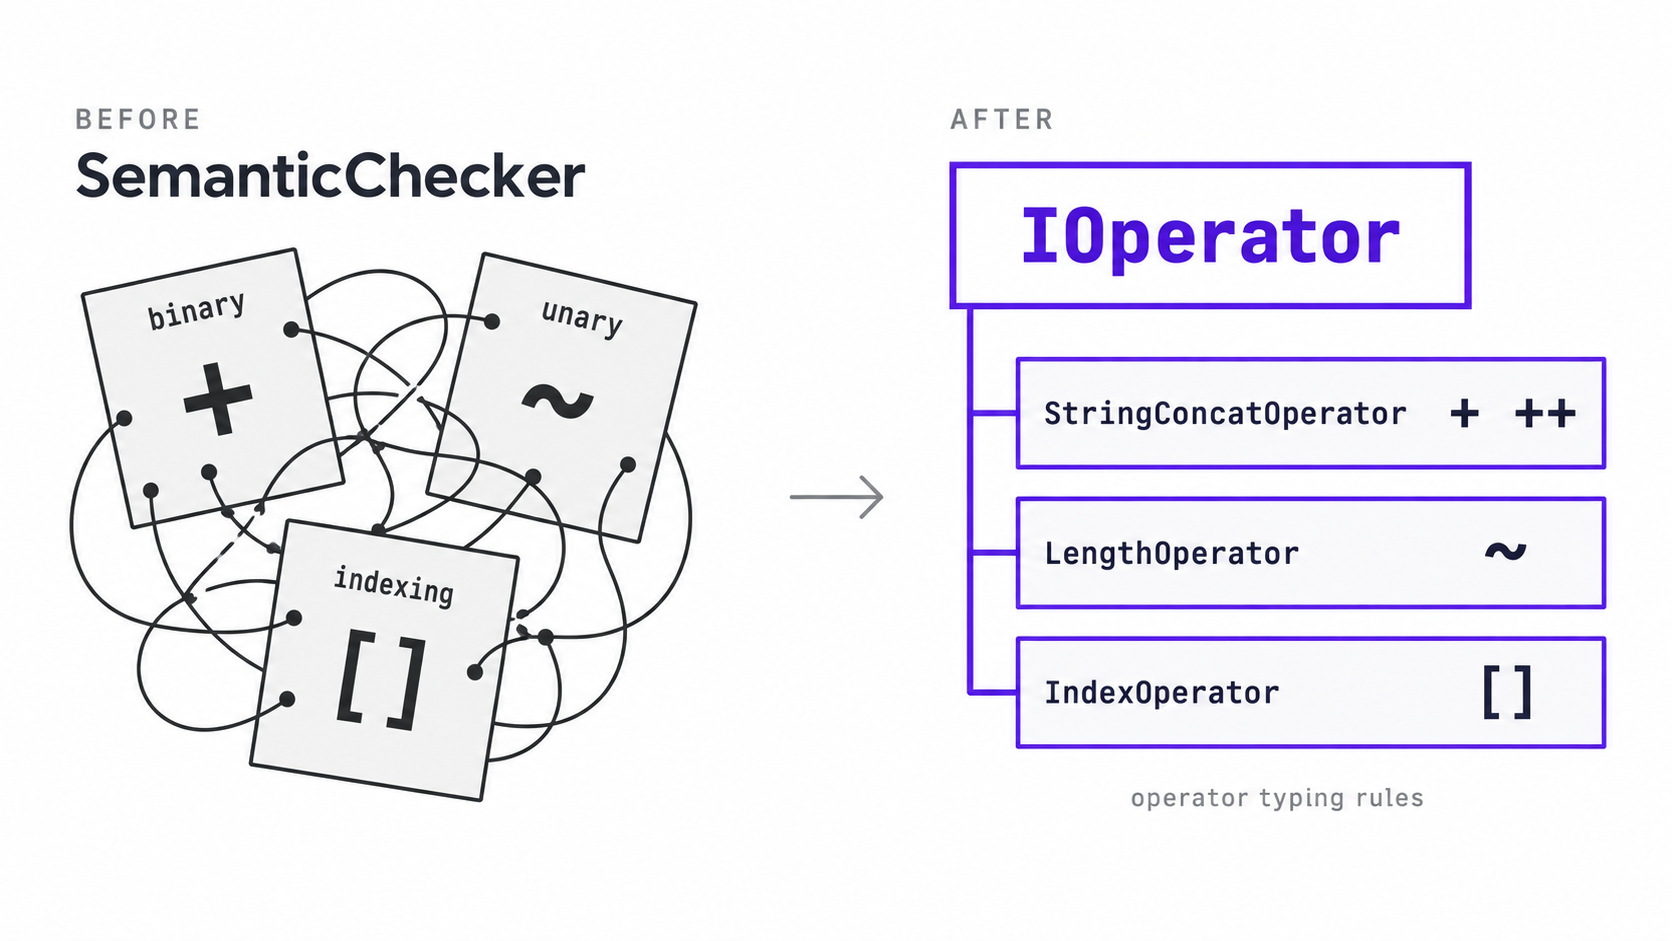
HydraScript ծրագրավորման լեզվի հեղինակը, որը գրված է C#-ով, պատմում է տողերի ինդեքսավորման և երկարության ստացման աջակցության ներդրման գործընթացի մասին…