
SGLang без магии: как устроены основные настройки инференса LLM

Статья на Habr от команды Ecom Tech посвящена глубокому разбору настроек популярного фреймворка для инференса LLM — SGLang. Автор отмечает, что при масштабировании задач инференса стандартных конфигураций становится недостаточно, и возникают проблемы с нехваткой памяти, очередями запросов и эффективностью использования GPU. В материале подробно рассматриваются пять ключевых групп настроек, критически важных для оптимизации производительности: различные виды параллелизма (TP, DP, CP, PP, EP), управление KV-кэшем (Radix Cache, HiCache), особенности вычислений в MoE-моделях, выбор бекенда для attention и механизмы спекулятивного декодирования. Цель статьи — помочь инженерам понять внутренние процессы пайплайна инференса, чтобы принимать обоснованные решения при настройке параметров в зависимости от конкретных нагрузок и аппаратных ограничений. Это руководство служит отличным подспорьем для тех, кто стремится выйти за рамки базовых настроек и добиться максимальной эффективности при работе с большими языковыми моделями.
This is a summary. Read the full article at the original source:
HabrПохожие

ИИ дешевеет, а ваш компьютер дорожает: как OpenAI и Anthropic устроили гонку цен
В сентябре на рынке ИИ произошел заметный сдвиг: OpenAI и Anthropic практически одновременно представили новые модели, стоимость использования которых…
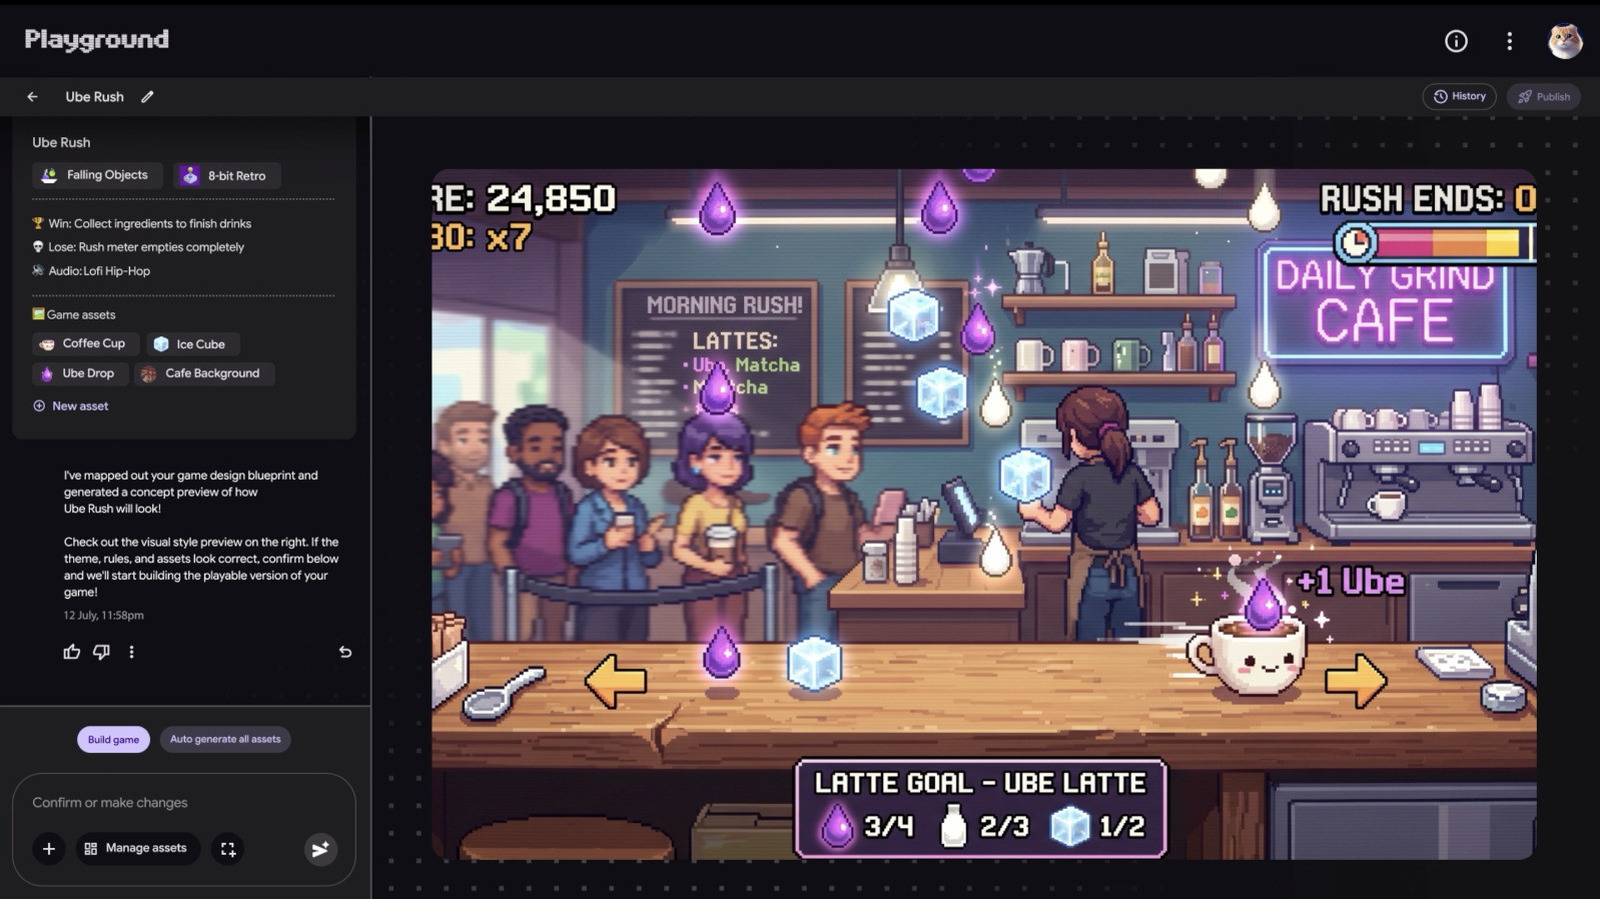
Экспериментальная платформа Playground от Google использует ИИ для создания игр
Google представила экспериментальную платформу Playground, которая использует генеративный искусственный интеллект для упрощения процесса создания игр…
Неочевидные возможности ИИ: почему стоит сохранять оптимизм
Автор статьи делится личным опытом использования искусственного интеллекта, отмечая, что многие специалисты недооценивают реальный потенциал современн…