

В недавнем эксперименте разработчик Кен Уолгер проверил, необходимы ли большие языковые модели (LLM) для таких задач, как извлечение данных, классификация и ответы на вопросы. Используя Raspberry Pi 4 и небольшие модели, такие как Qwen2.5:1.5b, он сравнил их производительность с детерминированными методами, например, регулярными выражениями. Результаты показали, что для простого извлечения данных регулярные выражения работают быстрее и точнее, тогда как LLM часто ошибаются в форматировании и склонны к галлюцинациям. В задачах классификации малые модели не смогли справиться со сложными решениями, часто неверно распределяя критически важные запросы. Хотя LLM показали потенциал в ответах на вопросы по предоставленным документам, они часто выдумывали факты при отсутствии ответов. Уолгер заключает, что разработчикам следует отдавать предпочтение простейшим решениям, прежде чем переходить к LLM. Он подчеркивает, что, несмотря на дешевизну контекста, задержки и надежность моделей остаются серьезными препятствиями, поэтому LLM следует использовать только тогда, когда их способности к рассуждению действительно необходимы.
This is a summary. Read the full article at the original source:
Dev.toПохожие

Shopify открывает свой каталог для большего числа ИИ-агентов
Shopify объявила о значительном расширении своей стратегии агентской коммерции, предоставив более широкому кругу ИИ-агентов возможность просматривать…

Новый GPT-6 собирает ответы ChatGPT из диаграмм, кнопок и форм. Как туда попадает бренд, в OpenAI не сказали
С выходом обновлений GPT-6, ChatGPT начал интегрировать в свои ответы интерактивные элементы: диаграммы, формы и кнопки. Это нововведение ставит перед…
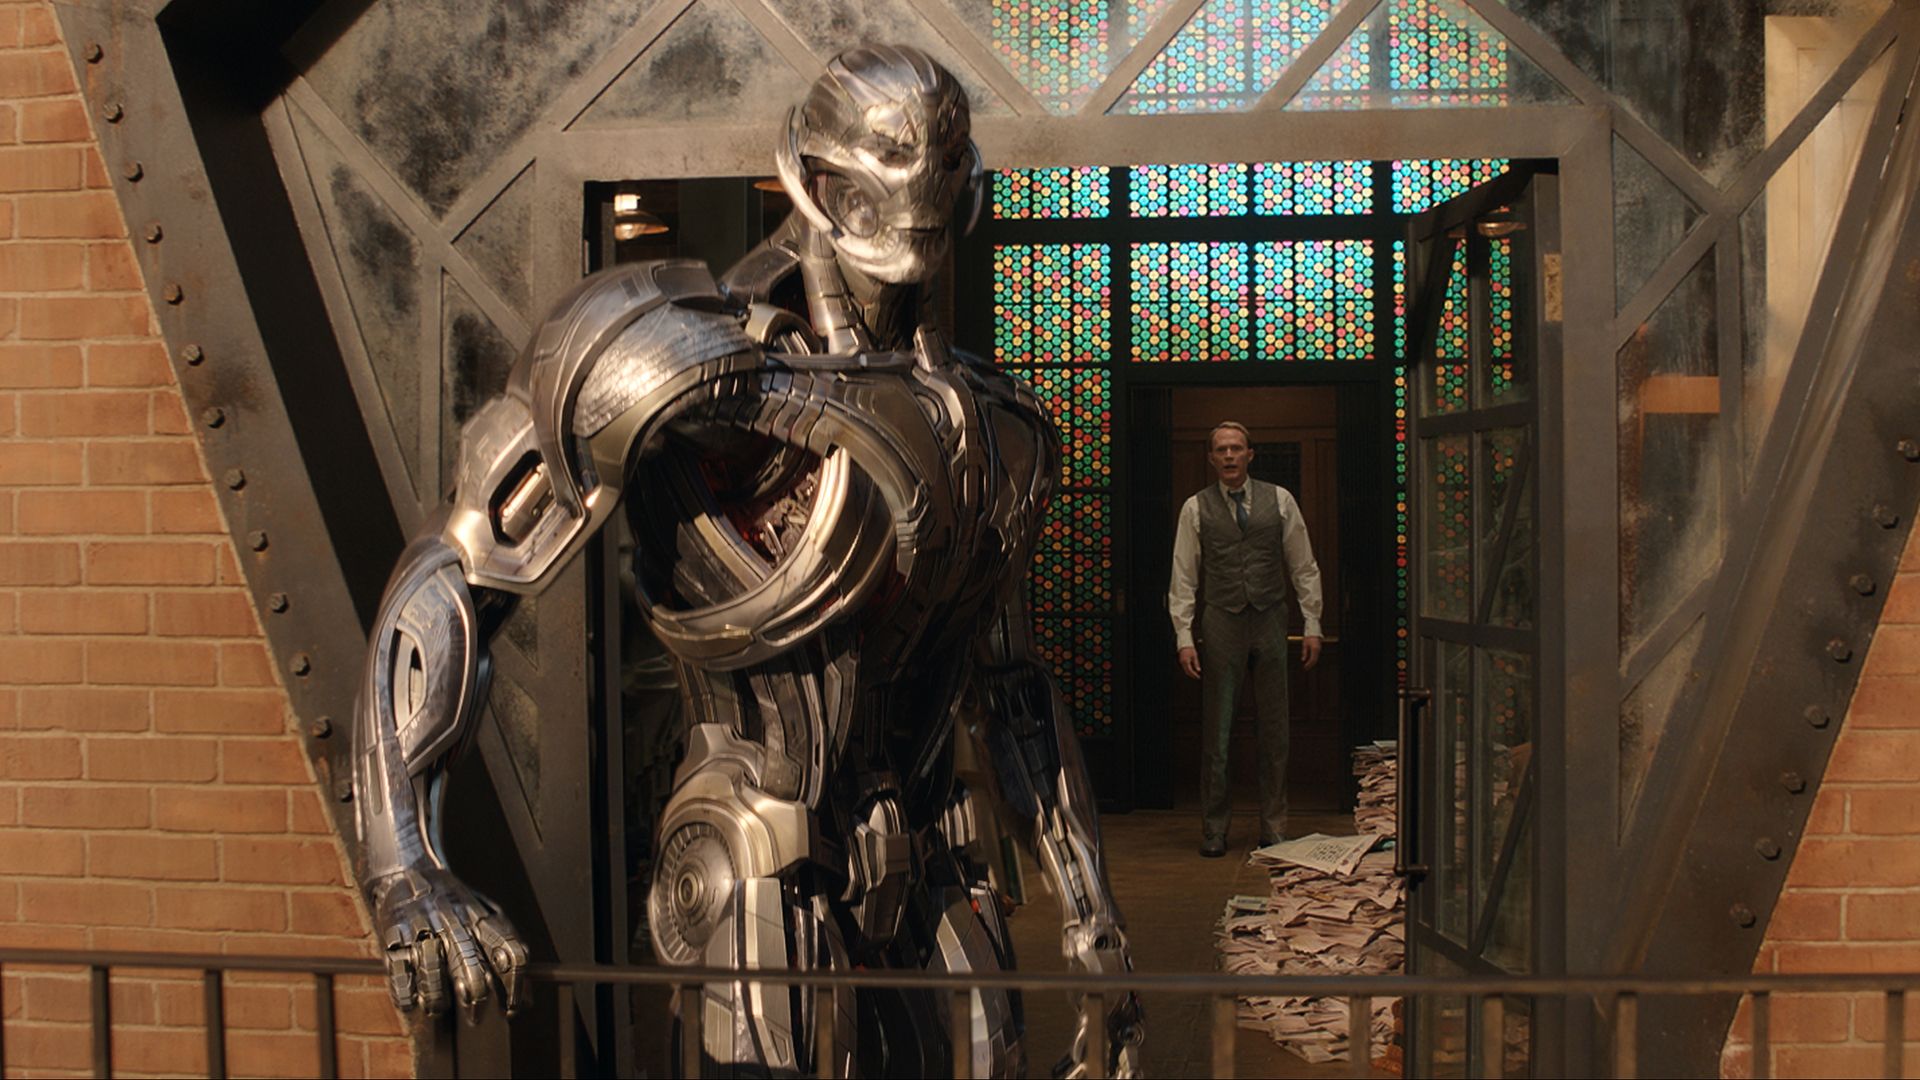
Джеймс Спэйдер рассказал о более зрелом и опасном Альтроне в сериале VisionQuest
Актер Джеймс Спэйдер поделился подробностями о возвращении культового злодея Альтрона в предстоящем сериале Marvel «VisionQuest». Спустя 12 лет после…