
SGLang-ը առանց մոգության. ինչպես են աշխատում LLM ինֆերենսի հիմնական կարգավորումները

Habr-ում հրապարակված այս հոդվածը՝ Ecom Tech թիմի կողմից, նվիրված է LLM ինֆերենսի հանրահայտ SGLang ֆրեյմվորքի կարգավորումների մանրամասն վերլուծությանը։ Հեղինակը նշում է, որ ինֆերենսի խնդիրները մասշտաբավորելիս ստանդարտ կոնֆիգուրացիաները բավարար չեն լինում, ինչը հանգեցնում է հիշողության սղության, հարցումների հերթերի և GPU-ի ոչ արդյունավետ օգտագործման։ Նյութում մանրամասն քննարկվում են կարգավորումների հինգ հիմնական խմբեր, որոնք կրիտիկական են արդյունավետության օպտիմալացման համար՝ զուգահեռականության տարբեր տեսակներ (TP, DP, CP, PP, EP), KV-քեշի կառավարում (Radix Cache, HiCache), MoE մոդելների հաշվարկների առանձնահատկությունները, attention-բեքենդի ընտրությունը և սպեկուլյատիվ դեկոդավորման մեխանիզմները։ Հոդվածի նպատակն է օգնել ինժեներներին հասկանալ ինֆերենսի փայփլայնի ներքին գործընթացները՝ կոնկրետ ծանրաբեռնվածության և սարքավորումային սահմանափակումների դեպքում հիմնավորված որոշումներ կայացնելու համար։ Այս ուղեցույցը հիանալի օգնություն է նրանց համար, ովքեր ձգտում են դուրս գալ հիմնական կարգավորումների շրջանակից և հասնել առավելագույն արդյունավետության մեծ լեզվական մոդելների հետ աշխատելիս։
This is a summary. Read the full article at the original source:
HabrԿապակցված

Արհեստական բանականությունը էժանանում է, իսկ ձեր համակարգիչը՝ թանկանում. ինչպես OpenAI-ը և Anthropic-ը գնային մրցավազք սկսեցին
Սեպտեմբերին արհեստական բանականության շուկայում նկատելի տեղաշարժ տեղի ունեցավ. OpenAI-ը և Anthropic-ը գրեթե միաժամանակ ներկայացրեցին նոր մոդելներ, որոն…
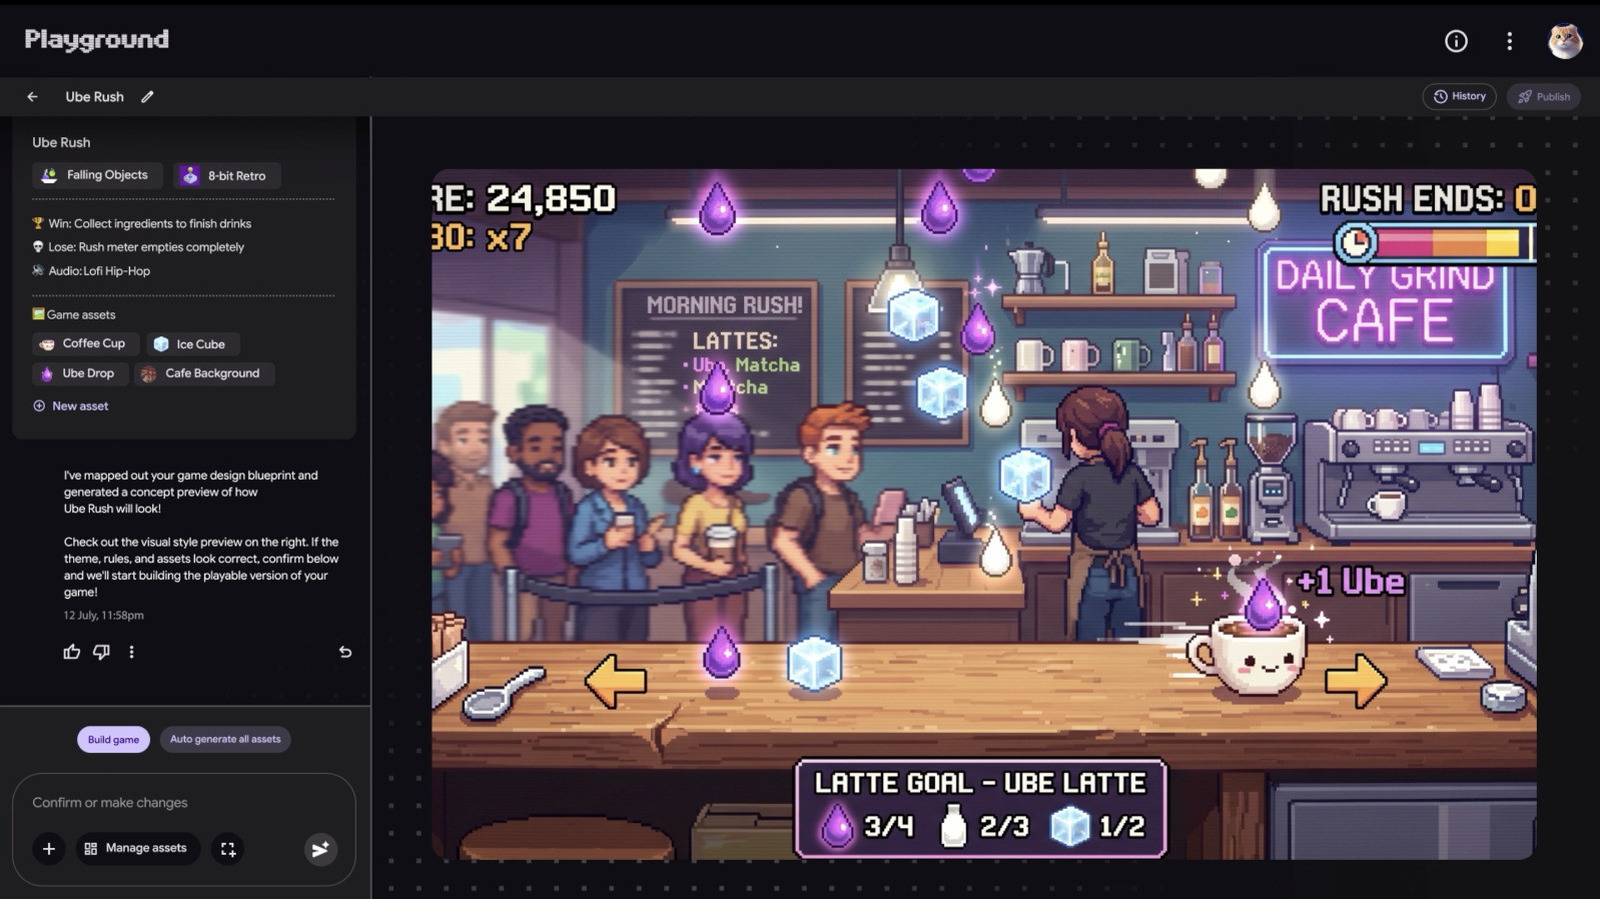
Google-ի փորձարարական Playground հարթակը օգտագործում է արհեստական բանականություն՝ խաղեր ստեղծելու համար
Google-ը ներկայացրել է Playground անունով փորձարարական հարթակ, որն օգտագործում է գեներատիվ արհեստական բանականություն՝ խաղերի ստեղծման գործընթացը պարզե…
Արհեստական բանականության ոչ ակնհայտ հնարավորությունները. ինչու պետք է լավատես մնալ
Հոդվածի հեղինակը կիսվում է արհեստական բանականության օգտագործման իր անձնական փորձով՝ նշելով, որ շատ մասնագետներ թերագնահատում են ժամանակակից նեյրոնային…