
Հրահանգների ներարկում HTTP վերնագրերում. ի՞նչ են ցույց տալիս 217 միլիոն վեբ պատասխանները
Signals Corps-ի կողմից 217 միլիոն վեբ պատասխանների վերլուծությունը բացահայտել է մտահոգիչ միտում՝ HTTP վերնագրերում հրահանգների ներարկման (prompt injection) խոցելիությունների տարածվածությունը: Քանի որ AI-ի վրա հիմնված գործակալներն ու LLM վեբ-սկրեյպերները դառնում են ավելի տարածված, նրանք հաճախ տվյալները ստանում են անմիջապես HTTP վերնագրերից՝ առանց պատշաճ մաքրման: Հետազոտությունը ցույց է տալիս, որ չարամիտ օգտատերերն արդեն իսկ ներդնում են հրահանգների ներարկման ծածկագրեր այս վերնագրերում՝ վեբ-երթևեկությունը մշակող AI մոդելները շահարկելու համար: Հրահանգները վերասահմանելու միջոցով հարձակվողները կարող են տվյալներ գողանալ կամ վտանգել AI-ի աշխատանքի ամբողջականությունը: Արդյունքները ընդգծում են անվտանգության կարևոր բացը՝ կոչ անելով մշակողներին վեբ-մետատվյալները դիտարկել որպես անվստահելի մուտքային տվյալներ: Այս հետազոտությունը շեշտում է LLM-ինտեգրված համակարգերը վերնագրերի վրա հիմնված հարձակումներից պաշտպանելու համար կոշտ ստուգումների անհրաժեշտությունը:
This is a summary. Read the full article at the original source:
Hacker News (YC)Կապակցված
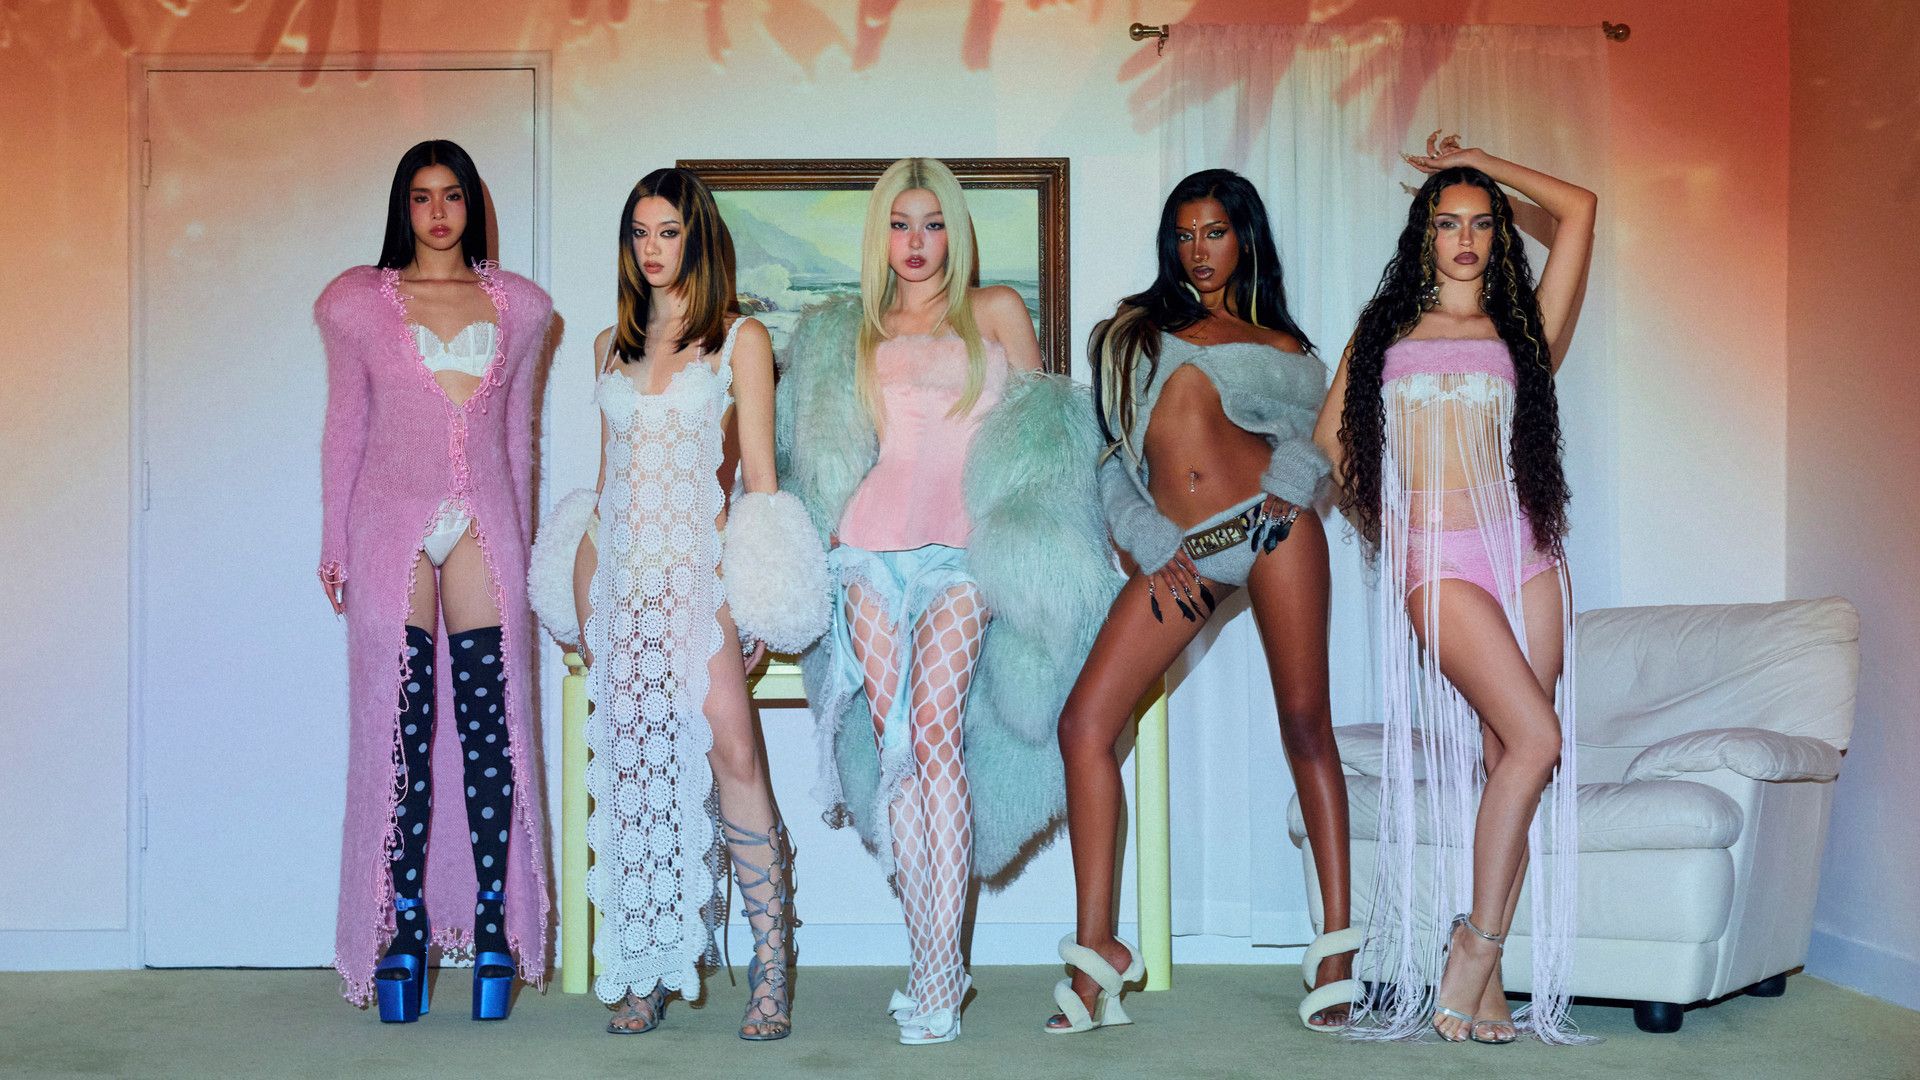
«KATSEYE: Wild Hearts» փոփ-վավերագրական ֆիլմը, որը պատմում է համաշխարհային KATSEYE աղջիկների խմբի հաջողության մասին, կթողարկվի հոկտեմբերի 16-ին: Ֆիլմը…
Windows-ի թարմացումը շտկում է Always On VPN-ի խնդիրը, սակայն նոր անսարքություններ է առաջացնում
Microsoft-ը թողարկել է KB5127646 և KB5127648 կուտակային թարմացումները՝ լուծելու «Always On VPN» գործառույթի կրիտիկական սխալը, որը նախկինում հանգեցնում…

Խոցելիության կառավարումը ոչ թե միավորների, այլ ձեր միջավայրին դրանց համապատասխանության մասին է
Dark Reading-ի վերջին զեկույցը ընդգծում է կազմակերպությունների կողմից խոցելիության կառավարման մոտեցման կարևոր փոփոխությունը: Փոխանակ հիմնվելու միայն վ…