
PlyLoom ասպարեզում՝ Qwen-ը ընդդեմ DeepSeek-ի

Habr-ում հրապարակված վերջին փորձարկման մեջ հեղինակը համեմատական վերլուծություն է անցկացնում երկու առաջադեմ լեզվական մոդելների՝ QWEN 3.8 MAX-ի և DEEPSEEK V4-ի պատասխանների վերաբերյալ: Հետազոտության հիմնական նպատակն է գնահատել նեյրոնային ցանցերի կողմից գեներացված գրաֆային պատասխանների որակն ու կառուցվածքը՝ նույնական խաչաձև հարցումների մշակման ժամանակ: Տվյալների վիզուալիզացիայի և մանրամասն համեմատության համար հեղինակն օգտագործել է PlyLoom հարթակը: Այս գործիքը թույլ է տալիս հստակ պատկերացում կազմել մոդելների տրամադրած պատասխանների տրամաբանության և ամբողջականության տարբերությունների մասին: Փորձարկումն ընդգծում է LLM-ների համեմատական թեստավորման կարևորությունը՝ կառուցվածքային տեղեկատվություն պահանջող խնդիրներում դրանց ուժեղ և թույլ կողմերը հասկանալու համար: Այս մոտեցումը օգնում է մշակողներին և հետազոտողներին ավելի լավ կողմնորոշվել գեներատիվ արհեստական բանականության արագ զարգացող ոլորտում՝ ընտրելով առավել հարմար գործիքներ կոնկրետ կիրառական խնդիրների համար:
This is a summary. Read the full article at the original source:
HabrԿապակցված
Microsoft-ի գործադիր տնօրեն Սաթյա Նադելլան անհատական համակարգիչները պատկերացնում է որպես «անվերջ ծրագրային գործարաններ» տեղային AI-ի միջոցով
Microsoft-ի գործադիր տնօրեն Սաթյա Նադելլան ներկայացրել է Windows համակարգիչների նոր տեսլականը՝ դրանք դիտարկելով որպես տեղային արհեստական բանականությամ…

Meta-ն գործարկել է Muse և Wonder AI մոդելները՝ գեներատիվ AI-ի ոլորտում մրցակցելու համար
Meta ընկերությունը պաշտոնապես ընդլայնել է իր գեներատիվ արհեստական բանականության պորտֆոլիոն՝ ներկայացնելով Muse և Wonder մոդելները։ Այս նոր գործիքները…
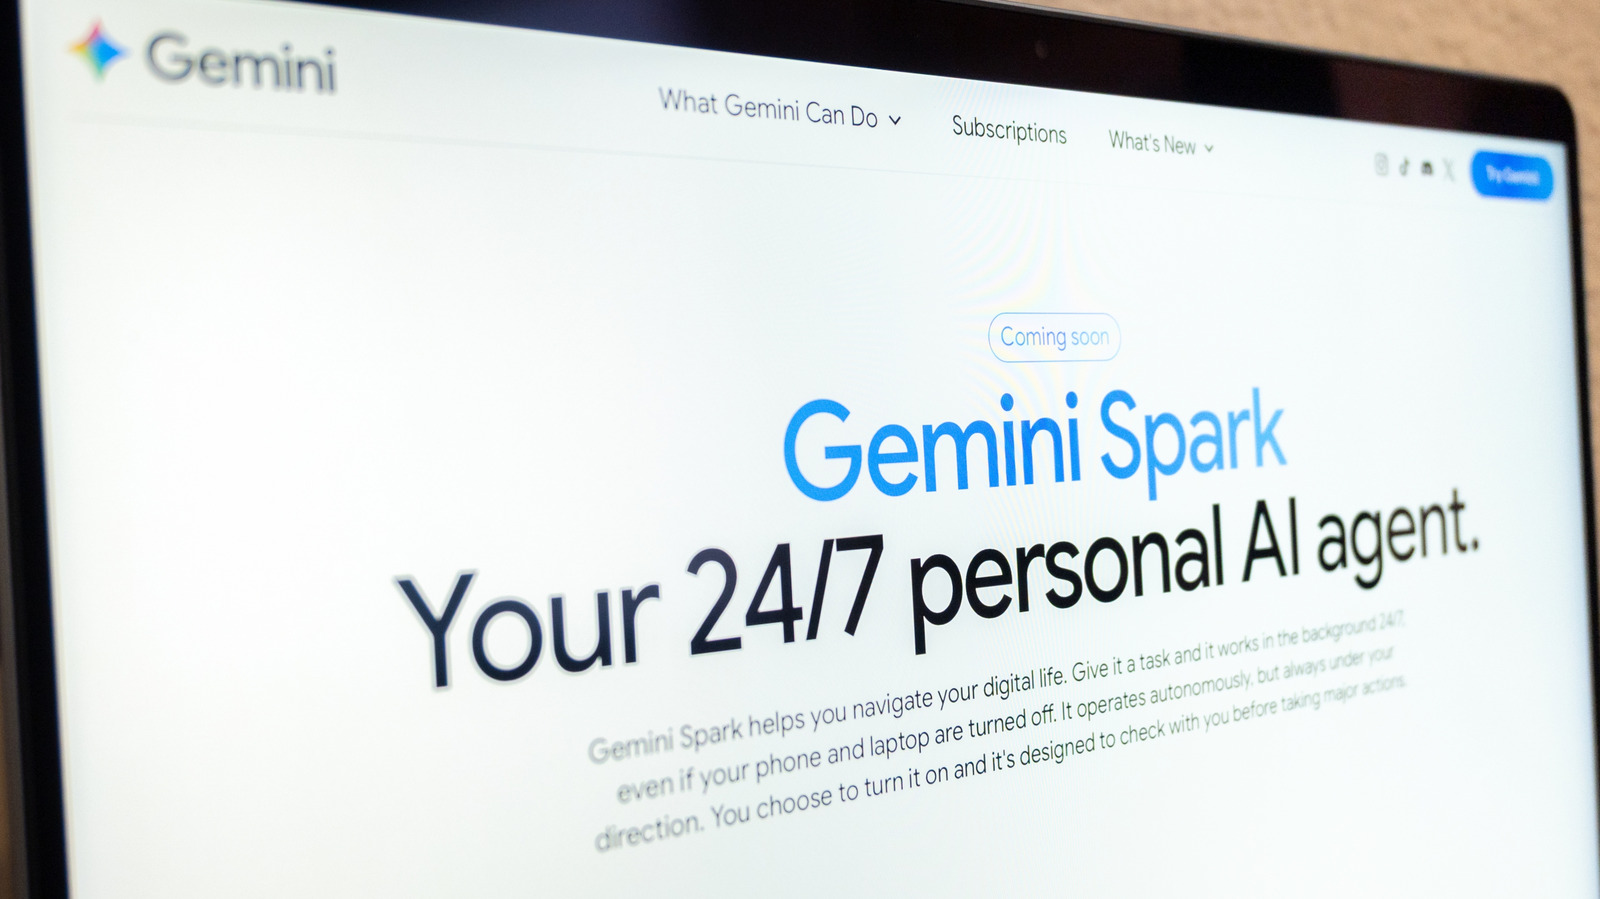
Ինչպես օգտագործել Google Gemini-ն առաջադրանքներն ավտոմատացնելու համար
Google-ն ավելի ու ավելի է ինտեգրում իր Gemini AI մոդելը իր էկոհամակարգում՝ օգնելու օգտատերերին պարզեցնել իրենց ամենօրյա աշխատանքային գործընթացները: Օգ…